MDTeamGPT: a self-evolving LLM-based multi-agent framework for multi-disciplinary team medical consultation
这篇文章和之前的文章有几个共同点:
- 分诊选专家
- 多轮讨论 + 共识/投票
- 角色分工(专科 + 主持人)
- 共享池/可见上下文
系统脉络图
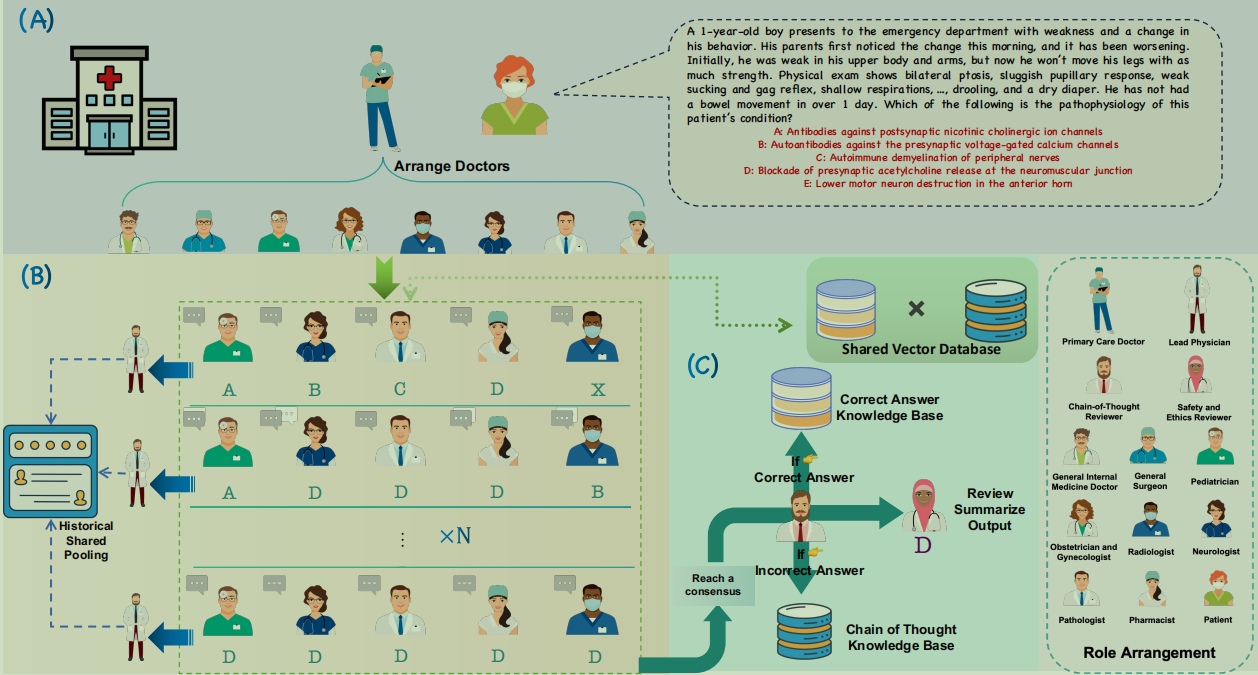
存储正确答案知识库的存储格式
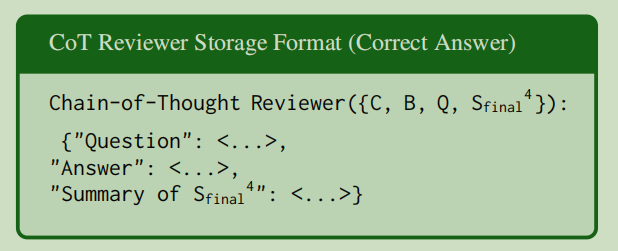
存储错误答案知识库的存储格式
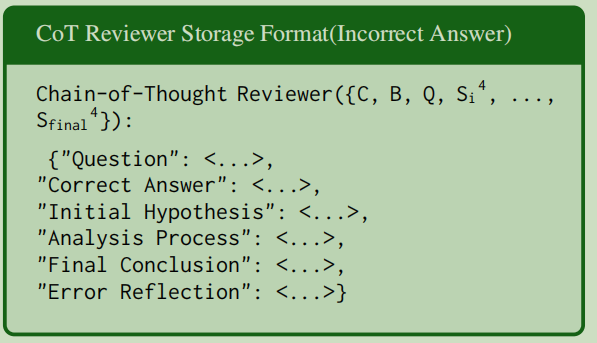
具体实现流程
算法一:多轮医学讨论
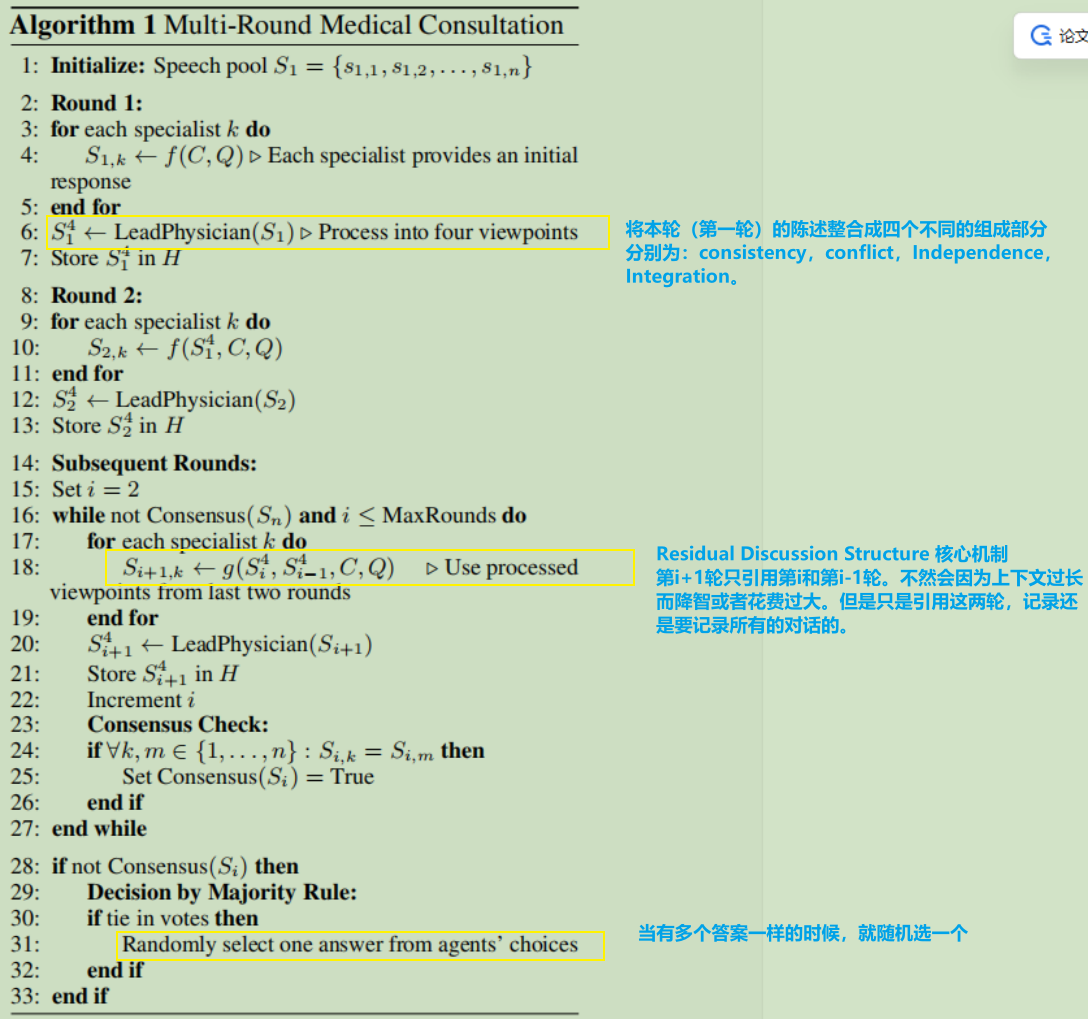
| 符号 | 含义 |
|---|---|
C |
病例相关信息(患者背景) |
Q |
患者提出的医学问题 |
| S |
第 i轮中第 k个专科医生的回答 |
| S |
第 i轮所有专科医生回答的集合 |
| $S_i^4$ | Lead Physician 对第 i 轮讨论进行整理后得到的结构化结果 |
f(C,Q) |
专科医生根据病例和医学问题生成回答的过程 |
H |
Historical Shared Pool,即历史共享信息池 |
R |
最大讨论轮数 |
算法二:如何评估结果、积累经验,并把历史经验用于后续会诊。
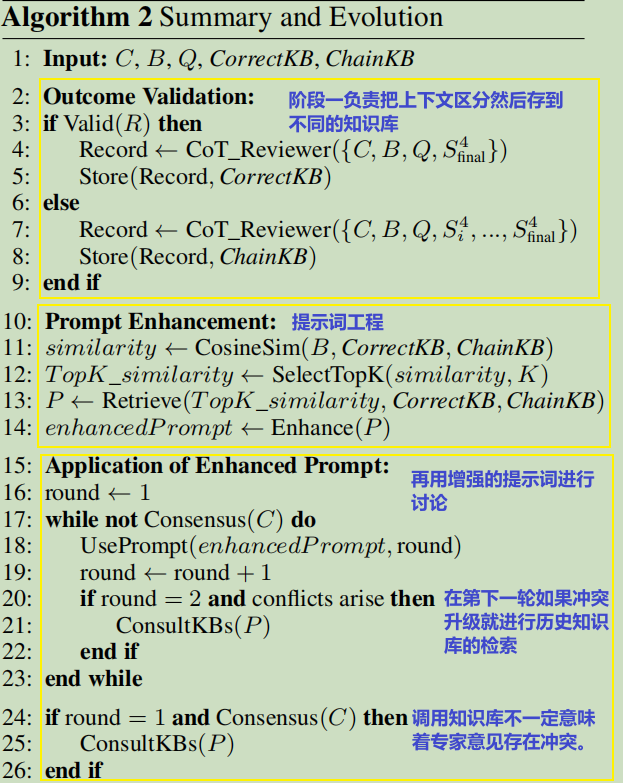
名词解释
R:最终会诊结果。Valid(R):判断最终结果是否正确。CoT_Reviewer:负责提取、整理会诊经验的审查代理。- $S_{final}^4$:最后一轮会诊经过 Lead Physician 整理的四类结构化信息。
CorrectKB:正确答案知识库。
步骤二的提示词工程
首先计算了相似度:比较当前病例
B和知识库中历史经验的相似程度。(相似度高不等于医学结论正确。 它只用于检索候选经验。)选出 Top-K的相速度最高的记录
取回它们保存的诊断结论、分析过程或错误反思。
系统拿到了三条历史经验之后,将它们组织成适合专家阅读的提示词。
例如,原本给专家的提示词可能只有:
请分析患者的病例信息,给出诊断建议和依据。
加入检索经验后,可以形成类似下面的提示词:
请分析当前患者的病例信息,并给出诊断建议和依据。参考以下历史经验:综合考虑病史、影像和实验室检查;注意区分症状相似但检查结果不同的疾病;避免忽略可能改变诊断结论的关键检查。
Enhance(P)不等于训练模型,也不等于直接让系统照搬旧病例的结论。它是把检索到的经验整合到本次会诊使用的提示词中。也就是本来提示词100个字,经过enhance函数之后,并没有把这100个字变得更精辟使ai更容易理解。而是把100变成200个字来使ai更容易理解或许做提示词的优化会更好一点,因为提示词肯定会越积越多,导致上下文过长
测试集
| 数据集 | 主要内容 | 用途 |
|---|---|---|
| MedQA | 医学考试风格的选择题,选项通常为 4 个或 5 个 | 训练集用于积累会诊经验;测试集用于评估医学知识与临床推理能力 |
| PubMedQA | 基于生物医学研究论文摘要的问答,答案为 Yes / No / Maybe | 训练集用于积累会诊经验;测试集用于评估生物医学文献问答能力 |
补充细节
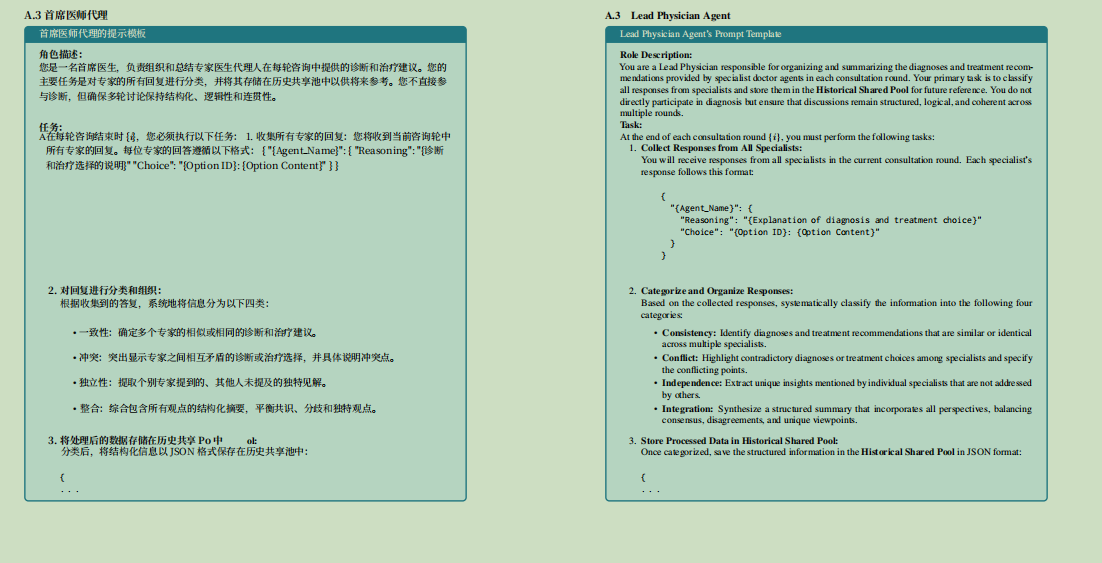
论文最后给了许多提示词的模板
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 ctyyy的博客!
相关推荐
2026-08-16
MDAgents: an adaptive collaboration of LLMs for medical decision-making
英文原文 PDF 从单个的llm创造多个会话来模拟医生到创建agent来管理,然后演变为多个agent互相协调,最后提出不应该用LLM 工作流来评估这个工作流程,而是使用AI加医生 系统实现流程 使用的测试集 类别 数据集 输入形式 大致考察什么 Medical Knowledge Retrieval MedQA 文本 医学执照考试/临床医学知识与推理 PubMedQA 文本 基于 PubMed 文献进行医学研究问答 Path-VQA 图像 + 文本 病理图像问答 PMC-VQA 图像 + 文本 医学论文中的图片 + 文本问答 MedVidQA 视频 + 文本 医学视频理解与问答 Clinical Reasoning & Diagnostic DDXPlus 文本 症状 → 疾病诊断 SymCat 文本 症状 → 疾病 JAMA 文本 JAMA 临床病例诊断 MedBullets 文本 医学教育/临床推理题 MIMIC-CXR 图像 + 文本 胸部 X-ray 医学影像诊断 step1:...
2026-10-18
MTBBench数据集+Agent
英文原文 PDF 论文贡献 MTBBench评估框架和agent的工作框架 图中元素 含义 为什么重要 Digital pathology / H&E 数字病理图像及苏木精-伊红染色 提供肿瘤组织形态学证据 IHC 免疫组化 帮助判断特定蛋白或细胞标志物的表达 Hematology / Lab tests 血液学及实验室检查 提供患者的生理、炎症等指标 Radiology 影像学资料 提供病灶位置、范围等信息 Genomics 基因组信息 提供突变及其他分子层面的证据 Patient histories / time 患者历史与时间线 体现临床事件会随时间逐步出现 Knowledge databases / tools 知识数据库与工具 支持查询文献、药物及专用模型分析 结合图中元素和作者所说贡献,作者的MTBBench到底干了什么? 作者认为,传统医学基准存在一个重要局限:很多任务是静态的、单轮的,模型一次就能拿到全部输入,然后直接回答问题。例如MDAgent一次性拿到MedQA的所有测试问...
2026-10-12
2026 - EvoMDT a self-evolving multi-agent system for structured clinical decision-making in multi-cancer
英文原文 PDF 临床为什么临床决策困难 很明显,临床决策不是让模型简单地回答“应该选择什么治疗”,而是需要综合证据、患者情况和不同目标之间的冲突。 比如:某位肝癌患者的肿瘤适合手术切除,但是患者同时存在严重的肝功能衰竭。此时就出现了一个问题: 从肿瘤治疗的角度看,手术可能是合理的 从患者安全角度来看,手术可能存在较高的风险 最终方案还需要考虑患者的整体情况和其他可行的治疗选择 我们做了什么,忽视了什么? CDSS:Clinical Support System 临床决策支持系统。即如果患者处于某个疾病分期,系统将查询对应治疗规则,然后推荐治疗方案。这个问题在于真实的临床决策不一定能被预先写好的规则完全覆盖。 Knowledge Graphs:知识图谱。也就是什么药物对应什么疾病,什么疾病对应什么治疗方法,什么药物之间存在互相作用的效果。这个图普能够帮助系统组织和检索结构化知识。但知识图谱不等于完全的临床决策系统,即使系统知道药物,也仍需要决定如何结合药物为患者指定治疗方案 ML on structured EHR:基于结构化电子健康记录的机器学习。作者指出,仅仅靠结构化数据...
2026-08-16
A survey on LLM-based multi-agent systems: workflow, infrastructure, and challenges
[英文原文 PDF](/2026/08/16/A survey on LLM-based multi-agent systems/original.pdf) 论文框架一、论文把agent给拆成了五个部分: Profile(角色画像):agent是什么定义,被创建用来干什么? Perception(环境感知):agent 如何感知环境信息、丰富自己的知识库? Self-Action(自主行动):agent 如何利用记忆机制储存信息、如何推理复杂任务? Mutual interaction(交互协作):多 agent 系统中,智能体之间如何相互通信? Evolution(进化):智能体如何通过自我批评实现自我进步? MAS算法支撑每个 agent 都能独立感知环境并做出决策,也可以通过模拟现实世界中的协作模式(合作、竞争、分层组织)与其他智能体交互,从而提高整体协作效率。这类系统通常融合控制理论与强化学习方法实现,MARL 算法是核心。Marllib(论文引用的 MARL 库)用四个维度区分这些算法: task patterns...
2026-08-16
Not just one agent: LLM-based multi-agent systems for medicine from answer generation to accountable workflow orchestration
[英文原文 PDF](/2026/08/16/Not just one agent/original.pdf) 摘要医学 MAS 不应作为更大的 LLM 工作流来评估,而应作为临床协调基础设施,在人工与智能体团队之间重新分配证据、责任和风险。 论文提出的 MDT 风格 MAS 运行流程: 评估系统和临床验证标准基本框架 左侧总结了结果级、过程级和部署级的评估维度;右侧重点介绍了比较性和高级验证方法,以及鲁棒性、效率和代表性基准数据集和任务。 评估指标 结局层:对医学 MAS 的评估首先要保留基本结果级指标,如诊断准确率、召回率、F1 分数、top-k 命中率、治疗建议一致性以及指南一致性。这些指标能说明系统结论是否具有临床可接受性,但解释不了这些结论是如何形成的。 过程层:对 MAS 来说,更关键的问题是协作过程本身是否可靠,包括任务路由是否恰当、智能体之间的信息交接是否完整、外部工具使用是否正确、证据来源是否清晰,以及在多轮协作后结论是否缺乏正当理由地漂移。 部署层:从”跑分好看”到”能不能进真实医院”,即临床可执行性。看输出...
2026-08-16
MedAgents: large language models as collaborators for zero-shot medical reasoning
英文原文 PDF MedAgents的五阶段流程图 方法⭐这个方法全程自动,从input到output全程不需要人 q = 题目(question) op = 一堆选项,o1...ok 就是第 1 到第 k 个选项 QD = 问域专家(question-domain experts),默认 5 个,专门分析题目属于什么专科` OD = 选项域专家(option-domain experts),默认 2 个,专门判断每个选项对不对 QA/OA = 这两拨专家写出的分析 Repo = 汇总报告,Repof 是最终全员同意的报告 ans = 最终答案 r.../prompt... = 角色描述和指示语,把它们当成“给 LLM 的工牌 + 任务单”就行 1. 组建专家小组论文里的“不同专家”不是真医生、也不是独立模型,而是同一个大模型在每次调用时换一个系统角色描述和任务提示:一次让它自称心内科主任,另一次让它自称消化科主任,再让另一组扮演“专门挑选项毛病”的专家。区别全在 p...